有用信息藏在大段文本里
文本提取器把正文、章节标题、邮箱、URL、域名、手机号、日期和价格集中到一个结果表。
文本提取器专注结构化提取,和 Regex Tester、Line Tools、Text Cleaner 互补但不重复。
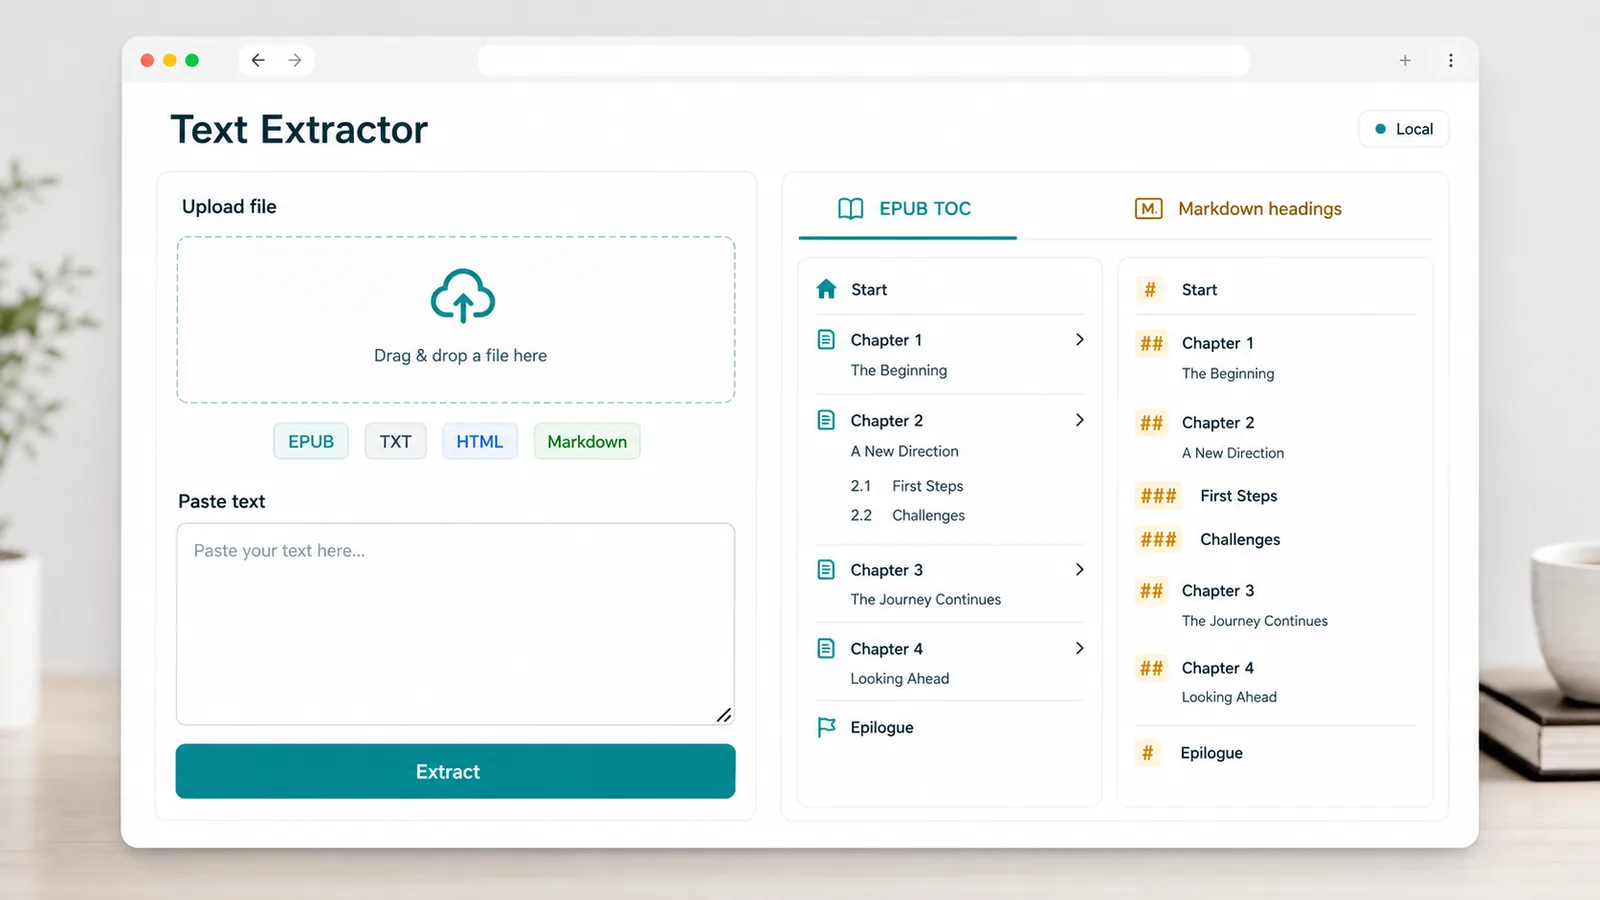
上传 EPUB、TXT、HTML、Markdown,或直接粘贴大段资料。
提取正文、章节标题、EPUB 目录结构和 Markdown 标题。
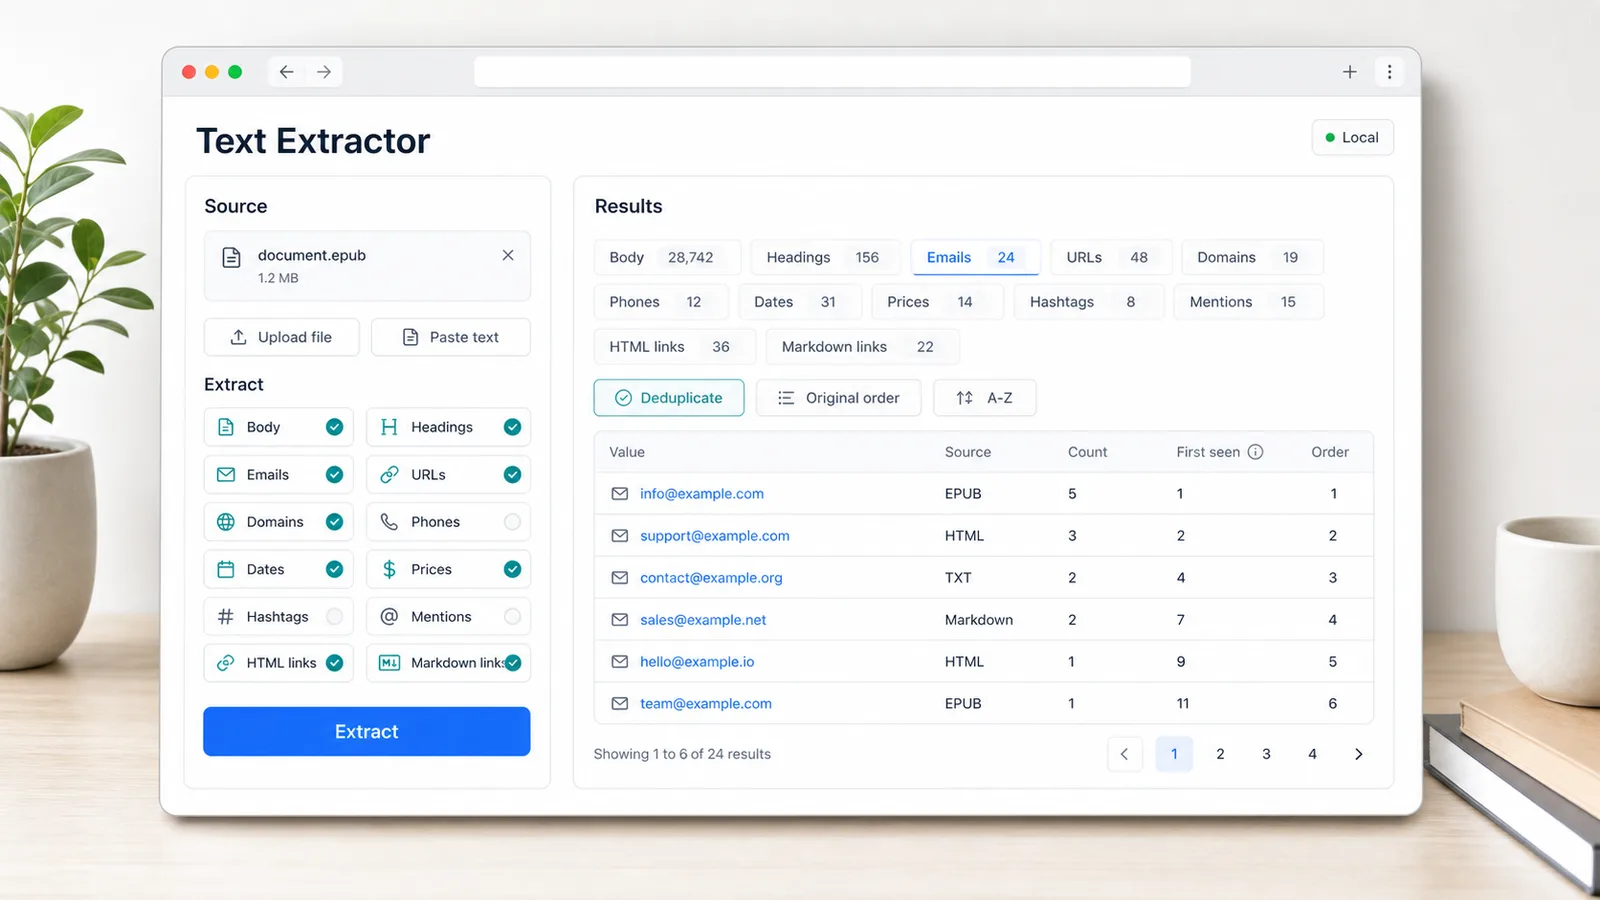
识别邮箱、URL、域名、手机号、日期、价格、Hashtag 和 Mention。
从 HTML a 标签和 Markdown 链接语法中提取链接和标签。
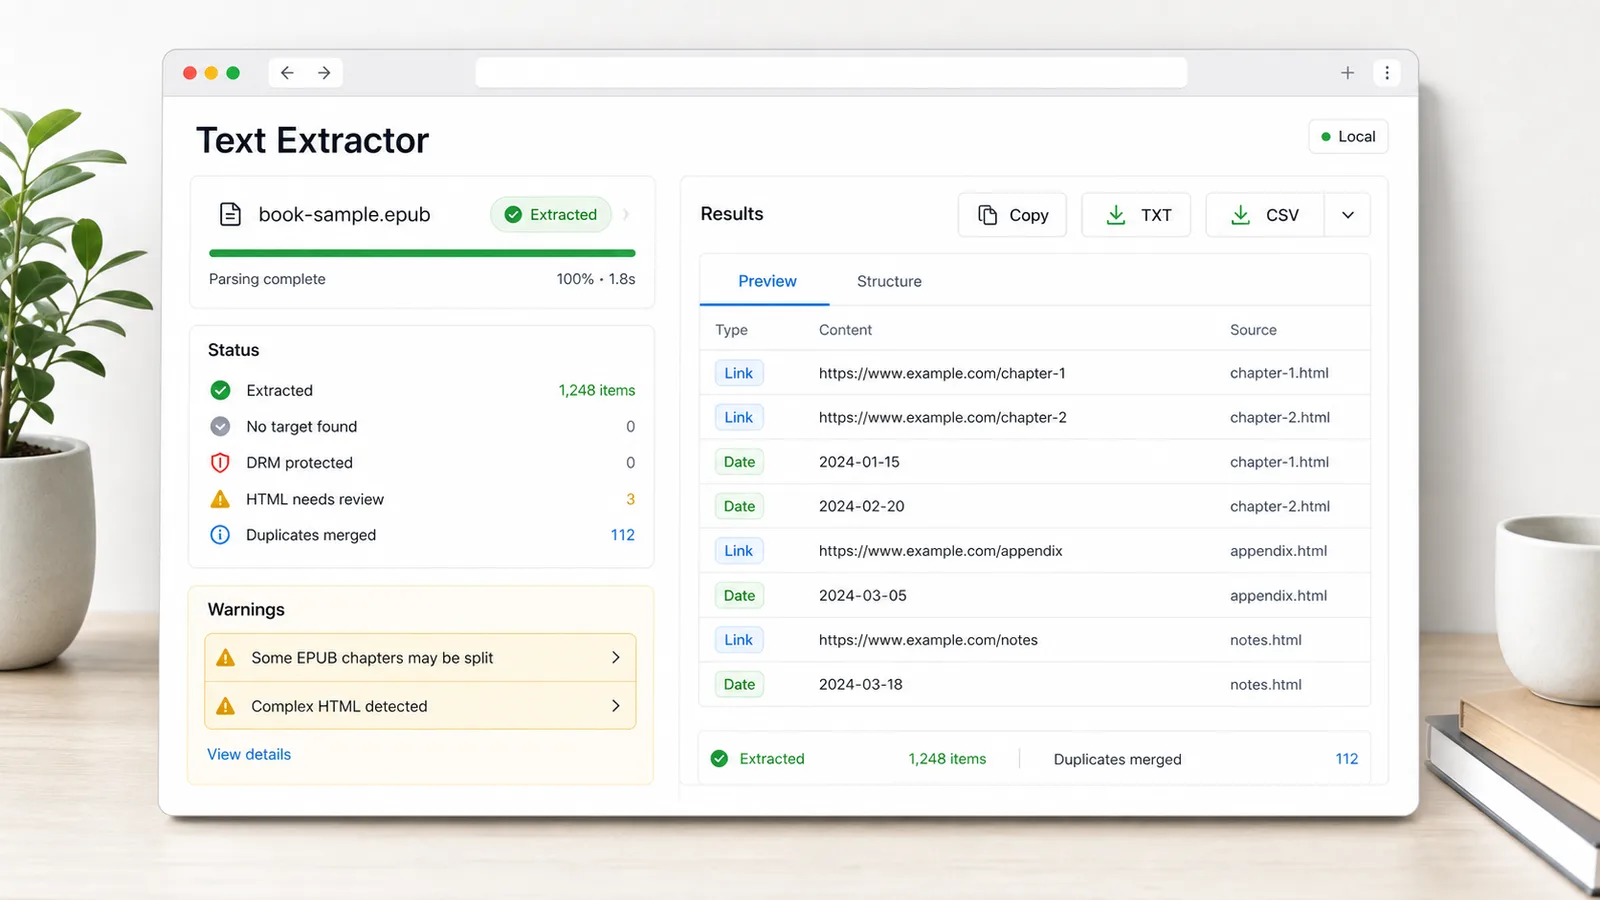
展示提取成功、无目标内容、DRM、空章节、HTML 不完整、复杂结构和清理提示。
结果可去重、按出现顺序或 A-Z 排序,并复制、下载 TXT 或 CSV。
文本提取器适合读书笔记、内容整理、外联整理、运营分析、资料归档、开发调试和 SEO 工作。
从电子书和长文档中提取章节、正文片段、目录和来源链接。
从邮件文本、网页源码和资料包中收集邮箱、URL、域名、手机号、日期和价格。
检查 HTML、Markdown、日志和爬取结果,不必先写自定义正则。
文本提取器不是单纯清理文本,也不是正则调试器,而是面向结构化结果的提取页面。
Regex Tester 用于测试自定义正则;文本提取器提供常见内容类型的一键提取。
Line Tools 处理行级排序去重;文本提取器先从文件或长文本中找出结构化结果。
带 DRM 的 EPUB 无法解析,脚本、样式、复杂嵌套或不完整 HTML 可能需要手动复核。
关于文本提取器解析、隐私和限制的说明。
不会。这个工具在浏览器本地解析支持的文件和粘贴文本。
不能。如果 EPUB 包含受保护内容的加密元数据,页面会提示无法解析受保护内容。
脚本、样式、复杂嵌套和不完整标签可能影响正文和链接提取,结果需要人工确认。