识别不可见字符
发现空格、换行、组合符号和标点,避免它们影响搜索、排版、导入或本地化 QA。
不用离开浏览器,就能理解一个字符的关键 Unicode 信息。
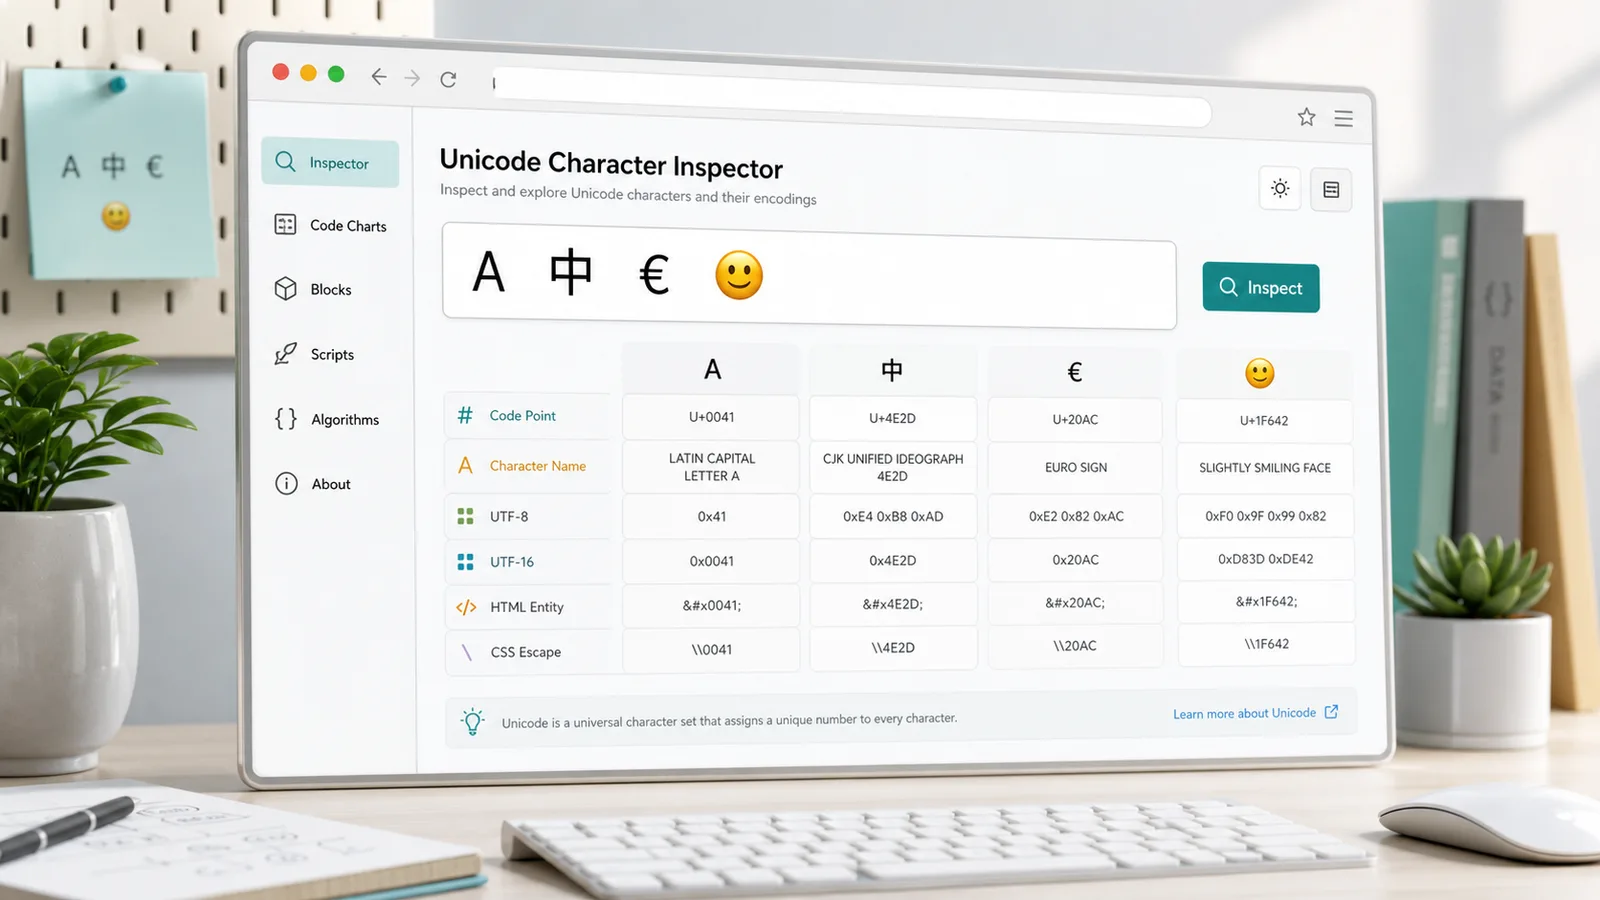
查看 U+ 值和 Unicode 字符名称,也能给控制符、私用区、非字符和保留码位提供可读标签。
定位文字系统、符号、标点、表情辅助字符和兼容区段所属的 Unicode 区块。
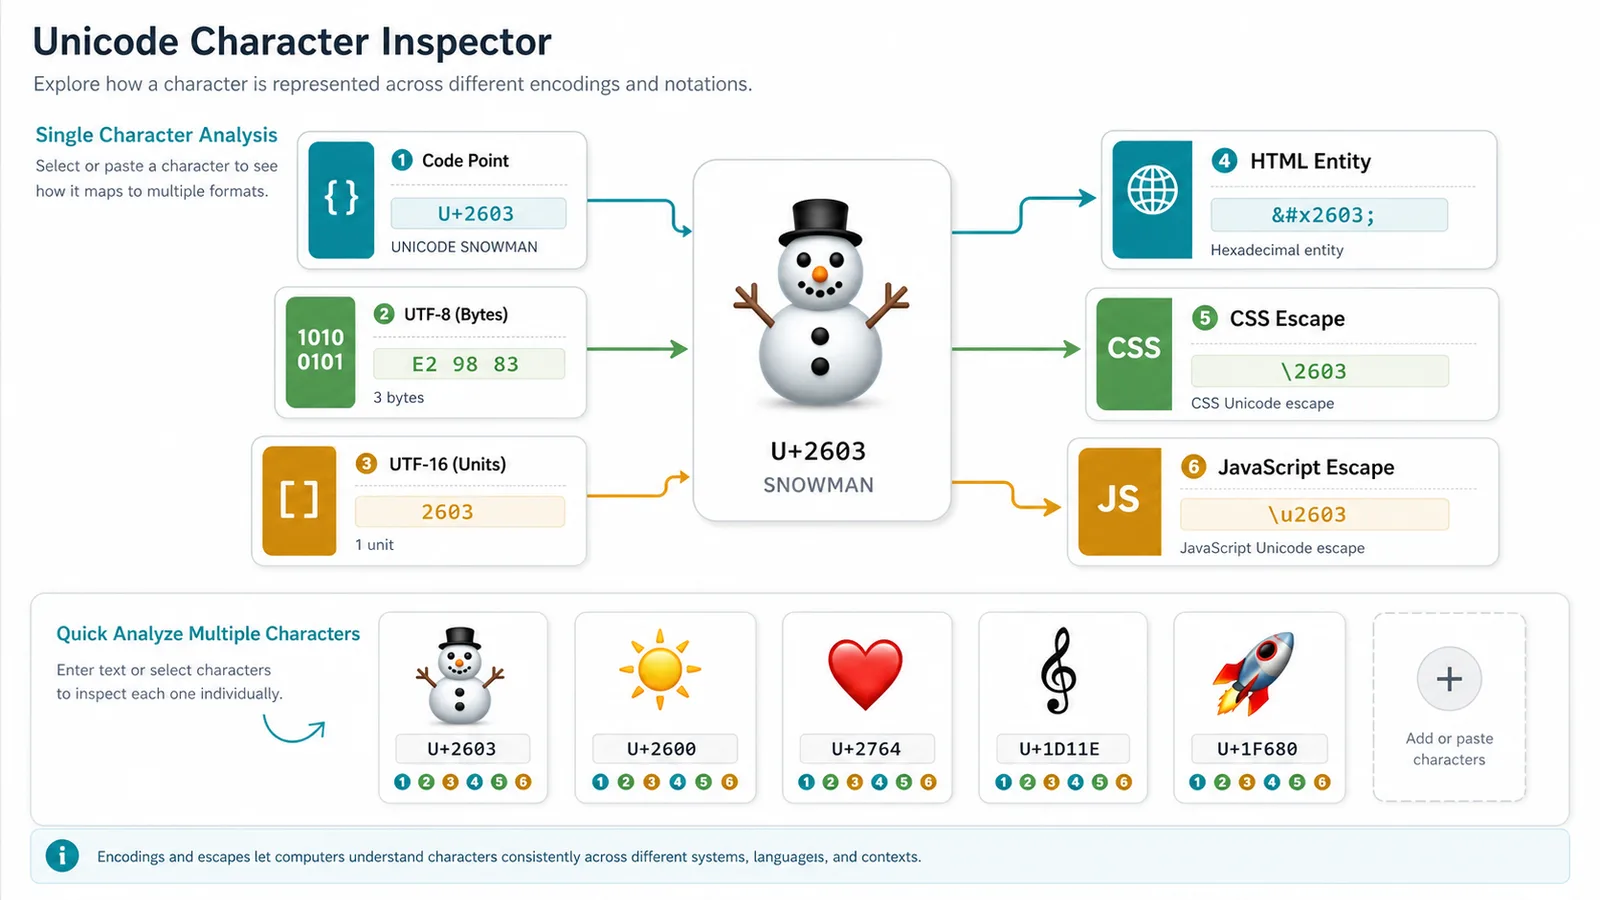
复制 UTF-8、UTF-16、HTML 实体、CSS 转义和 JavaScript 转义,用于文档和代码。
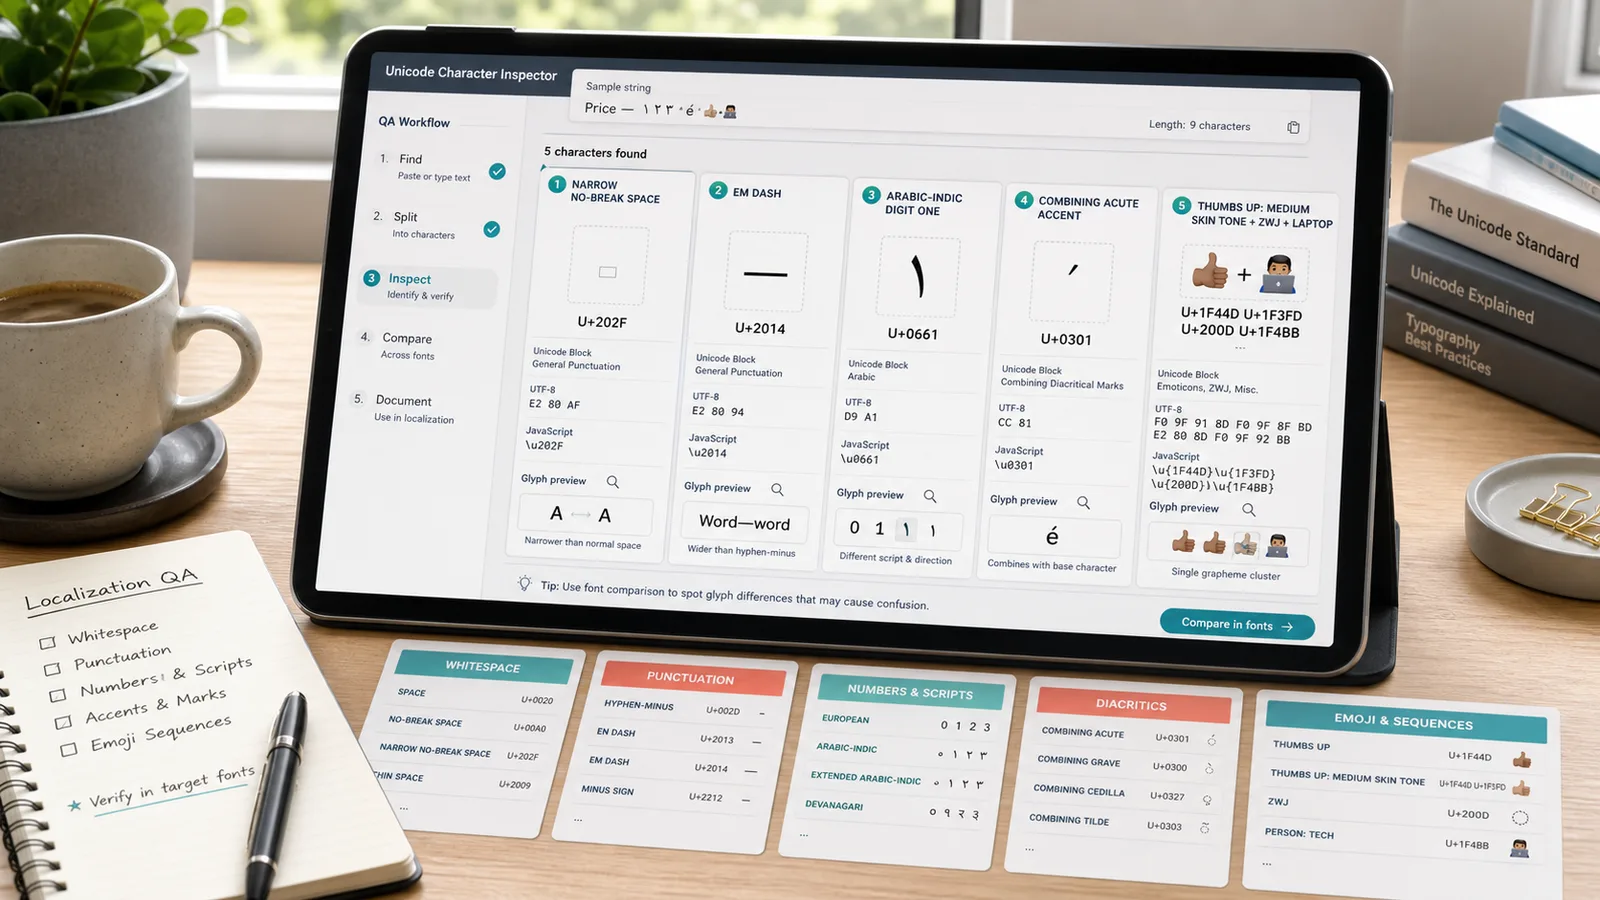
粘贴一整段文本逐个查看码位,也可切换字素模式保留组合表情和重音字母。
空格、制表符、换行和组合符号会以可读预览显示,更容易调试隐藏字符。
检查过程使用浏览器 API 和内置 Unicode 数据在本地完成,粘贴内容不会上传。
粘贴、拆分、查看,然后复制需要的精确值。
在输入框中放入一个符号、复制的界面文案、多语言内容、表情、空白或混合字符串。
按码位模式适合精确查看 Unicode 标量值;按字素模式适合把组合表情和重音字符视为一个可见字符。
查看字形预览、Unicode 码位、字符名称、区块、UTF-8、UTF-16、HTML 实体、CSS 转义和 JavaScript 转义。
用复制按钮把结果放入错误报告、字体 QA、翻译工单、CSS 内容、JavaScript 测试或文档。
面向开发者、翻译人员、字体设计人员、编辑和符号查询用户。
为 CSS 内容、HTML 文档、JavaScript 字符串、测试和数据样例确认精确转义。
识别本地化字符串中的隐藏空格、错误标点、意外组合符和特定文字系统字符。
在选择回退字体、测试覆盖范围或反馈缺字前确认字符名称和区块。
关于码位、名称、区块、编码、转义格式和隐私的回答。
它会检查每个字符,并报告 Unicode 码位、字符名称、Unicode 区块、UTF-8、UTF-16、HTML 实体、CSS 转义和 JavaScript 转义。
可以。粘贴整段字符串后,Unicode 字符检查器会拆分成多个条目。按码位模式更精确,按字素模式会保留组合后的可见字符。
不会。Unicode 字符检查器使用浏览器本地编码 API 和内置 Unicode 数据运行。
有些可见字符是序列,例如带修饰符的表情,或字母加组合符号。字素模式会把这些序列放在一起显示。